Nebluna Analytics
Sistema de pronóstico de demanda para cafeterías que convierte un CSV de ventas diarias en un pronóstico a 30 días con intervalos de confianza, servido por un backend de Prophet + FastAPI en GCP Cloud Run.
Plataforma de pronóstico de series de tiempo de extremo a extremo: un modelo Prophet envuelto en un servicio FastAPI, contenerizado con Docker y desplegado en Google Cloud Run, más un dashboard en Streamlit donde el dueño de una cafetería sube su histórico de ventas y obtiene predicciones, bandas de confianza y métricas de error del modelo.
Galería
Descripción del Proyecto
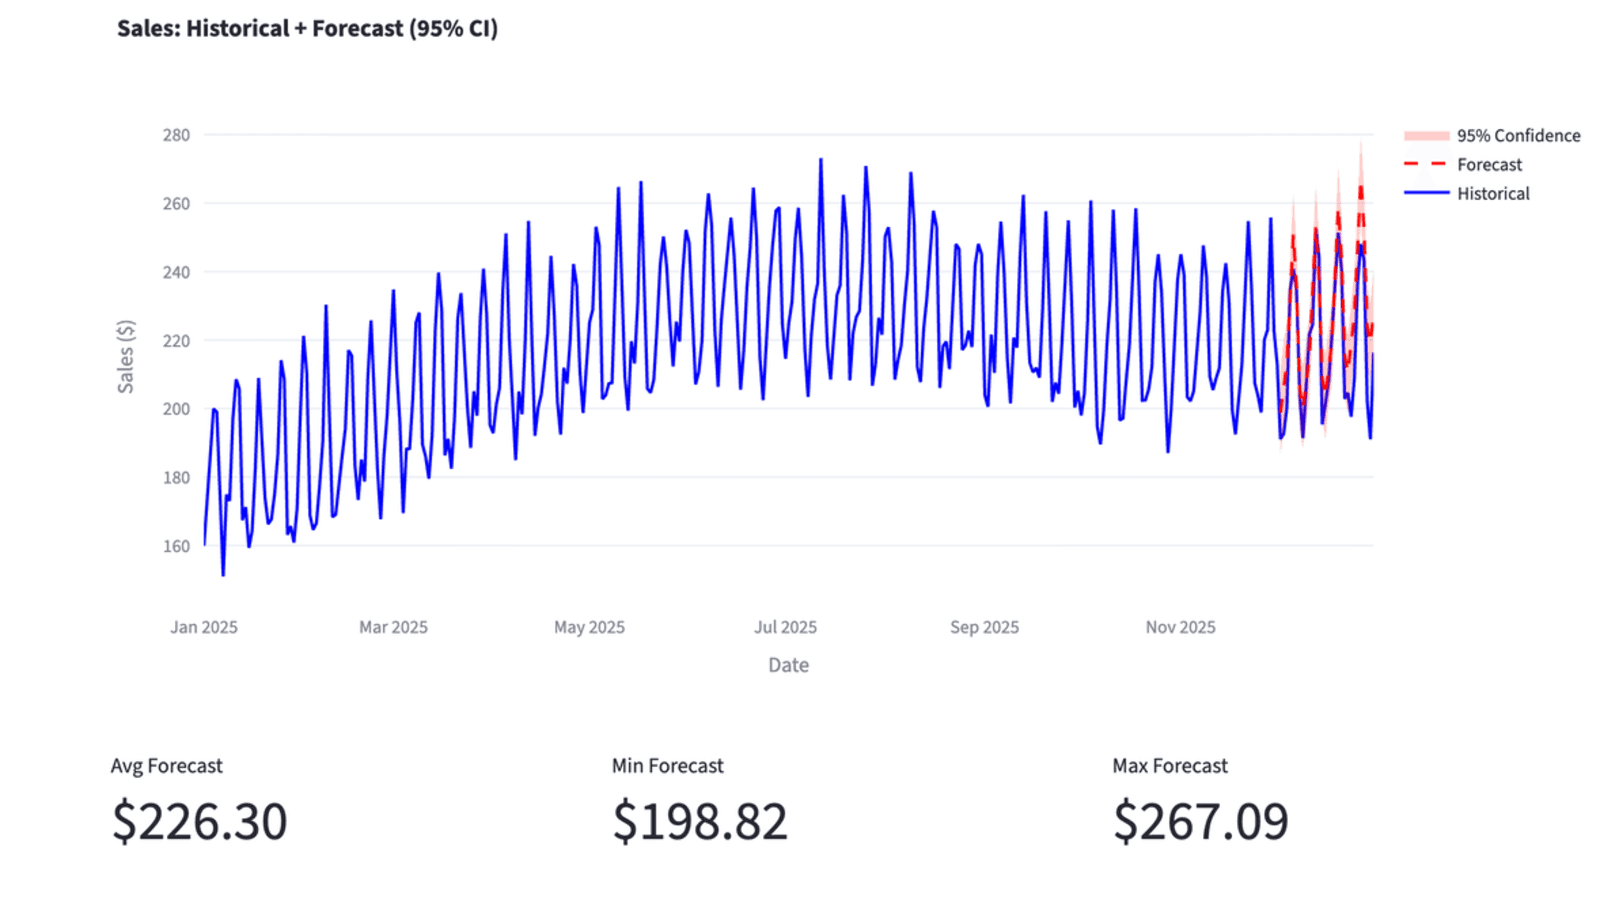
Nebluna Analytics pronostica la demanda diaria de cafeterías. Subes un CSV con el histórico de ventas, eliges un horizonte de entre 7 y 90 días y obtienes un pronóstico con banda de confianza del 95% más las métricas de error del modelo. Es un modelo Prophet servido por un servicio FastAPI en GCP Cloud Run, con un dashboard en Streamlit encima.
Implementación Técnica
Capa de Modelo
DataProcessor se encarga de la carga, validación y limpieza: verifica el contrato date / sales, exige un mínimo de 30 días de historia y normaliza el dataframe a la forma que Prophet espera. DemandForecaster envuelve el modelo: lo entrena, reserva la cola de la serie para evaluación y genera fechas futuras con límites de confianza del 95%. Prophet descompone la serie en tendencia más estacionalidad multiplicativa semanal y anual, así que el efecto del día de la semana queda separado de la deriva anual.
Capa de API
Un servicio en FastAPI expone cuatro endpoints:
GET /health: verificación de vida para Cloud RunPOST /api/v1/upload: recibe un CSV, entrena el modelo y devuelve métricas de ajustePOST /api/v1/forecast: genera n días hacia adelante, opcionalmente con intervalos de confianzaGET /api/v1/stats: estadísticas resumen del dataset cargado
Peticiones y respuestas están tipadas con Pydantic, así que la documentación OpenAPI se genera a partir de las mismas definiciones contra las que el servicio valida. Una jerarquía de excepciones propia devuelve un mensaje útil ante un CSV mal formado en lugar de un stack trace.
Evaluación
El modelo se evalúa sobre una cola reservada de la serie y no sobre los datos con los que se ajustó. En el dashboard se muestran tres métricas: MAE, el error promedio en pesos, que es el número con el que dimensionar un pedido; MAPE, el mismo error como porcentaje, comparable entre negocios de distinto tamaño; y RMSE, que castiga más los errores grandes y delata a un modelo que casi siempre acierta pero de vez en cuando falla feo.
Dashboard
Una app en Streamlit consume la API y organiza la salida en tres pestañas, Historical, Forecast y Metrics, con gráficas interactivas de Plotly. La barra lateral concentra la carga del CSV, un slider de horizonte de 7 a 90 días y un toggle para los intervalos de confianza.
Despliegue
La API está contenerizada y corre en GCP Cloud Run, construida para arm64 y amd64 para que la misma imagen funcione en una laptop con Apple Silicon y en la infraestructura de Google. Cloud Build maneja el CI/CD desde cloudbuild.yaml, y una alerta de presupuesto limita el gasto mensual. Prophet se apoya en extensiones C de NumPy y Pandas que se rompen al mezclar paquetes de conda y pip en un mismo entorno, así que la frontera está fijada por regla: conda para desarrollo local, wheels de pip dentro de la imagen de Docker.
Pruebas
pytest cubre el pipeline de procesamiento de datos y los endpoints de la API: fallos de validación, entradas mal formadas y el camino feliz.
El Reto
- Las ventas de una cafetería tienen una estacionalidad semanal fuerte más una tendencia anual lenta, y un promedio simple borra ambas
- Un pronóstico sin estimación de error no le sirve a quien tiene que decidir cuánto insumo pedir
- El modelo tenía que ser usable por el dueño del negocio, no solo desde un notebook
- La cadena de dependencias de Prophet (extensiones C de NumPy/Pandas) se rompe con facilidad entre el desarrollo local y los contenedores Linux
El Enfoque
- Prophet modela directamente la estacionalidad semanal y anual multiplicativa, de modo que la tendencia y el efecto del día de la semana se mantienen separados
- Cada predicción incluye una banda de confianza del 95%, y el modelo se evalúa sobre una cola reservada de la serie
- Un dashboard en Streamlit consume la API: subes un CSV, eliges el horizonte y lees la gráfica
- Conda para desarrollo local y wheels de pip dentro de Docker, con la frontera documentada para que los entornos nunca se mezclen
Resultados
- En producción en dos plataformas: Streamlit Cloud para el dashboard y GCP Cloud Run para la API
- Cuatro endpoints REST con documentación OpenAPI autogenerada y payloads validados con Pydantic
- MAE, MAPE y RMSE expuestos en la interfaz, calculados sobre una cola reservada de la serie
- Build de Docker multiplataforma (arm64 + amd64) con CI/CD en Cloud Build y una alerta de presupuesto de $10/mes
Impacto
El dueño de una cafetería sube un CSV de ventas y obtiene un pronóstico de demanda con su margen de error, desde el navegador y sin escribir código.
Detalles del Proyecto
Objetivo
Darle a las cafeterías pequeñas un pronóstico de demanda que puedan operar desde el navegador, con el modelo servido detrás de una API REST en vez de vivir en un notebook.
Tema
Series de tiempo aplicadas a la planeación de inventario en pequeños negocios.
Fecha
3 de agosto de 2026